そんなときに困ることは、
・”1,234″のようにカンマが入った金額を変換できない
・文字列か数値かの判定をどう書けばいいか分からない
ですね。
エラー文を読んでも「invalid literal for int()」としか出ないので、原因が分からず止まってしまう方も多いです。
そこで今回は、**文字列を数値に変換する基本から、エラーになる原因の見分け方、実務での対処法**までをまとめます。
・エラーになる6つの原因と対処法
・isdigit()が使えない理由
・金額を扱うときのDecimal
・実務パターン(CSVの合計)
今回は、これらについてまとめます!
・**全角数字「123」は int() でそのまま変換できる**(ただし全角の小数点「.」はエラー)
・変換できないときは ValueError、値が None のときは TypeError になる
・**isdigit() は判定に使えない**(True でも失敗する/False でも成功するケースがある)
・金額の計算は float ではなく **Decimal** を使う
完成イメージ
基本の変換と、つまずきやすいポイントをまとめた実行結果です。
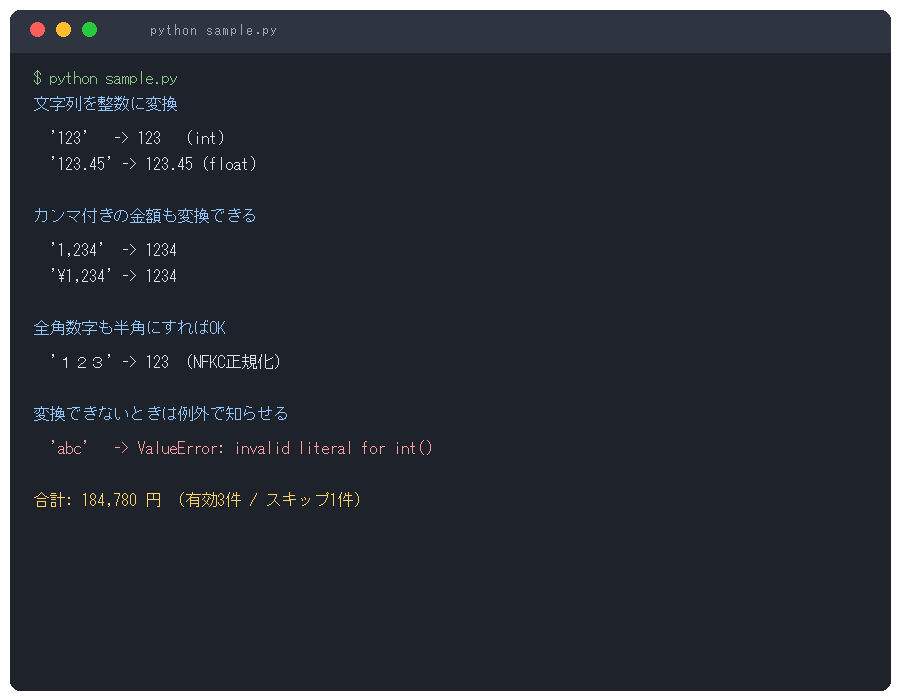
「123」はそのまま、「1,234」はカンマを取ってから、というように**前処理を挟むのがポイント**です。
もくじ
基本:int() と float() を使う
文字列を数値にするには、整数なら int()、小数なら float() を使います。
s = "123"
n = int(s)
print(n)          # 123
print(type(n))    # <class 'int'>

f = float("123.45")
print(f)          # 123.45
print(type(f)) # <class 'float'>文字列を数値にすると、足し算や比較ができるようになります。
a = "10"
b = "20"

print(a + b)              # 1020(文字列の連結になってしまう)
print(int(a) + int(b))    # 30(数値の足し算)
「なぜか 1020 になった」というのは、変換を忘れたときに起きる定番のミスですね。
そのまま変換できる書き方(早見表)
| 文字列 | int() | float() | ポイント |
|---|---|---|---|
| “123” | 123 | 123.0 | ふつうの数字 |
| ” 123 “ | 123 | 123.0 | 前後の空白は自動で無視される |
| “+5” / “-5” | 5 / -5 | 5.0 / -5.0 | 符号もOK |
| “1_000” | 1000 | 1000.0 | アンダースコア区切りもOK |
| “000123” | 123 | 123.0 | 先頭の0は無視 |
| “1e3” | エラー | 1000.0 | 指数表記はfloatのみ |
| “.5” / “5.” | エラー | 0.5 / 5.0 | 小数点の前後は省略可 |
| “nan” / “inf” | エラー | nan / inf | 特殊な値もfloatなら通る |
基数を指定すると16進数・2進数も変換できる
第2引数に基数を渡すと、10進数以外も変換できます。
print(int("1A", 16))      # 26(16進数)
print(int("0x1A", 16))    # 26(0x が付いていてもOK)
print(int("1010", 2))     # 10(2進数)
print(int("77", 8))       # 63(8進数)
エラーになる6つの原因と対処法
まずは全体像です。
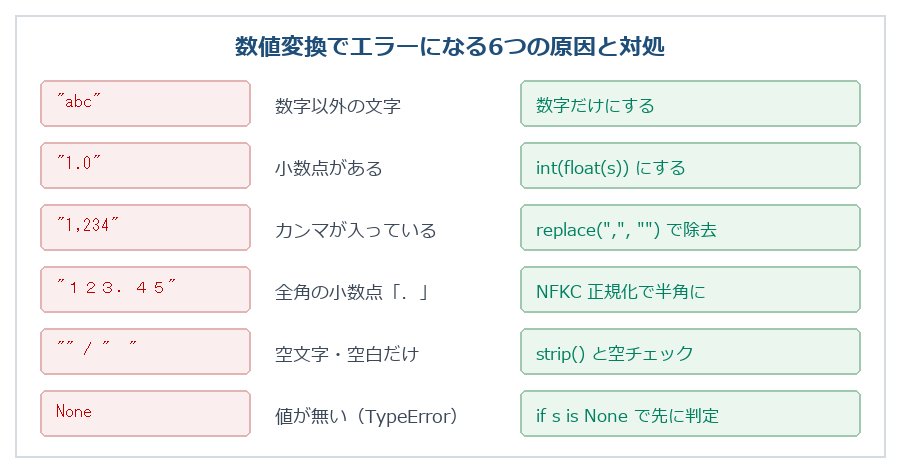
① 数字以外の文字が入っている
ValueError: invalid literal for int() with base 10: ‘abc’
「base 10」は「10進数として読めなかった」という意味です。
② 小数点が入っているのに int() を使った
print(int("1.0"))          # エラー
print(int(float("1.0")))   # 1(一度floatにしてからintへ)
「1.0」は整数に見えますが、int() は小数点を受け付けません。int(float(s)) の順で変換しましょう。
③ カンマや通貨記号が入っている
CSVやExcelから持ってきた金額は、この形になっていることが多いです。
s = "¥1,234"

s = s.replace("¥", "").replace(",", "")   # 記号とカンマを取る
print(int(s))                             # 1234
④ 全角数字・全角記号が混じっている
ここは誤解されやすいポイントです。全角数字「123」は int() でそのまま変換できます。
print(int("123"))          # 123(全角でも通る)
print(float("123"))        # 123.0
print(float("123.45"))   # 123.45(全角数字+半角の小数点)
print(float("123.45")) # エラー(全角の小数点「.」)数字は変換できても、全角の小数点「.」や全角カンマ「,」はエラーになります。
全角を半角にそろえたいときは、NFKC正規化が便利です。
import unicodedata

s = unicodedata.normalize("NFKC", "123.45")
print(s)            # 123.45(全角が半角になる)
print(float(s))     # 123.45
⑤ 空文字や空白だけ
print(int(""))       # エラー
print(int("   "))    # エラー
print(float("")) # エラーCSVの空欄はこれに当たります。strip() で空白を取ってから、空かどうかを判定しましょう。
⑥ 値が None(TypeError になる)
TypeError: int() argument must be a string, a bytes-like object or a real number, not ‘NoneType’
JSONやデータベースから来た値が None のときに起きます。ValueError ではなく TypeError なので、exceptの書き方に注意してください。
try:
    n = int(value)
except (ValueError, TypeError):     # 両方まとめて受ける
n = 0・「base 10」と出たら10進数として読めない文字が混じっている
・数値の前処理は「記号を取る→全角を半角にする→空白を取る」の順で
判定に使えるメソッドはある?(isdigit() は使えません)
「変換できるかどうかを先に判定したい」と考えて isdigit() を使う方が多いのですが、**これは危険です。**
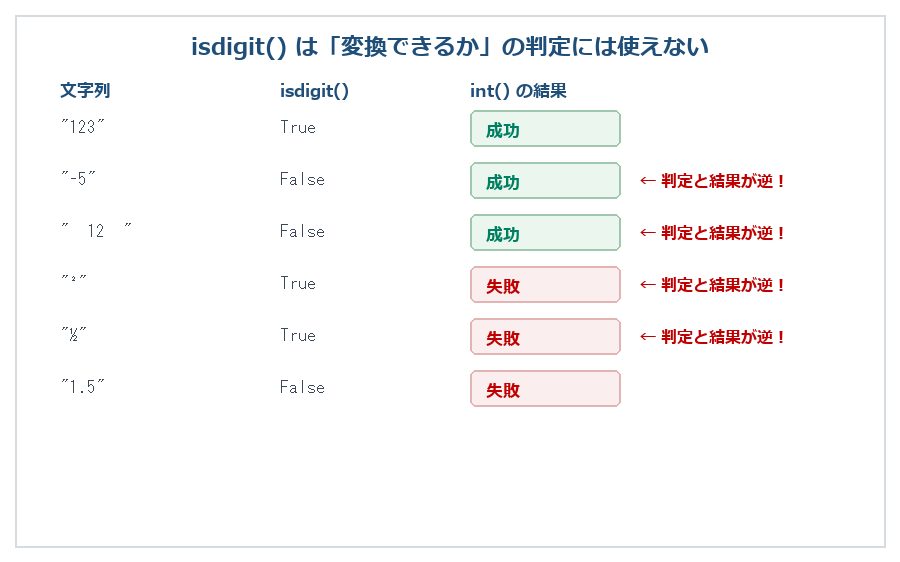
| 判定 | isdigit() の結果 | int() の結果 | 判定と一致する? |
|---|---|---|---|
| “123”.isdigit() | True | 成功 | 一致 |
| “-5”.isdigit() | False | 成功 | ズレる |
| ” 12 “.isdigit() | False | 成功 | ズレる |
| “²”.isdigit() | True | 失敗 | ズレる |
| “½”.isdigit() | True | 失敗 | ズレる |
| “1.5”.isdigit() | False | 失敗 | 一致 |
isdigit() が False でも変換できるものがあり、True でも失敗するものがあります。
理由は、isdigit() が「文字が数字かどうか」を見ているだけで、符号・空白・小数点・変換可否を見ていないからです。
3つのメソッドの違いは次のとおりです。
| メソッド | 判定するもの | “²” | “½” | “一” | int()の可否と一致する? |
|---|---|---|---|---|---|
| isdecimal() | 10進数の数字 | False | False | False | いちばん近い |
| isdigit() | 数字(上付き含む) | True | False | False | ズレる |
| isnumeric() | 数値(漢数字含む) | True | True | True | ズレる |
結論:判定せずに、try/except で書くのが正解です。
def to_int(s, default=0):
    """文字列を整数にする。変換できなければ default を返す。"""
    if s is None:
        return default                      # None は先に弾く
    try:
        return int(str(s).replace(",", "").strip())
    except ValueError:
        return default
この形なら、判定のズレを気にせず安全に変換できます。
金額を扱うときは Decimal を使う
小数を float で計算すると、**わずかな誤差**が残ります。
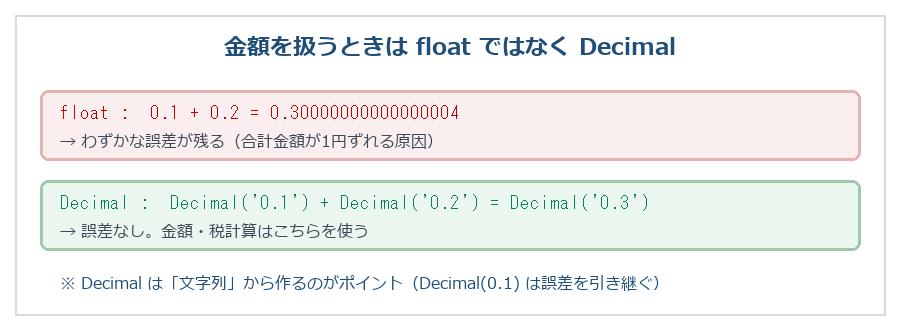
print(0.1 + 0.2)          # 0.30000000000000004

from decimal import Decimal
print(Decimal("0.1") + Decimal("0.2")) # 0.3金額の合計が1円ずれる原因になるので、お金の計算はDecimalを使いましょう。
Decimal は「文字列」から作るのがポイントです。Decimal(0.1) と書くと、誤差を持ったまま取り込まれてしまいます。
from decimal import Decimal

print(Decimal(0.1))       # 0.1000000000000000055511151231257827021181583404541015625
print(Decimal("0.1"))     # 0.1

# 四捨五入も round() ではなく quantize を使う
print(round(1.005, 2))                          # 1.0(誤差の影響を受ける)
print(Decimal("1.005").quantize(Decimal("0.01")))   # 1.00
変換の流れ(図で確認)
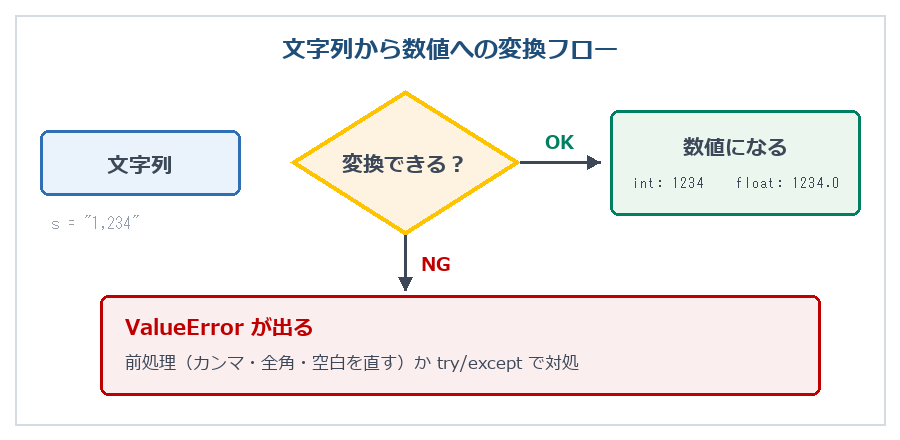
「変換してみる → ダメなら前処理」の順で考えると整理しやすいです。
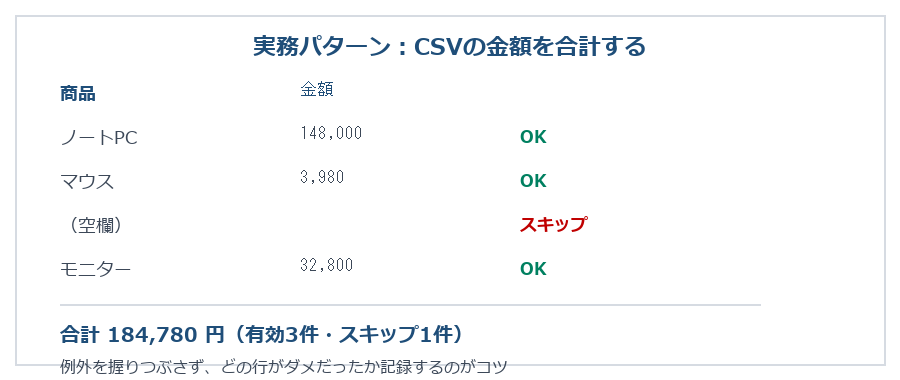
実務パターン:CSVの金額を合計する
実務でいちばんよくある形をまとめました。
import csv
from decimal import Decimal, InvalidOperation

total = Decimal("0")
skipped = []

with open("uriage.csv", encoding="utf-8") as f:
    for row in csv.DictReader(f):
        raw = (row["金額"] or "").replace(",", "").strip()
        try:
            total += Decimal(raw)
        except InvalidOperation:
            skipped.append(row["商品"])      # どの行がダメかを記録

print(f"合計: {total:,} 円")
print(f"スキップ: {skipped}")
合計: 184,780 円
スキップ: ['合計なし']ポイントは例外を握りつぶさないことです。どの行が変換できなかったかを記録しておくと、あとから確認できます。
よくある間違い
| 間違い | 起きること | 正しい書き方 |
|---|---|---|
| int(s) をいきなり使う | ValueErrorで止まる | try/except か前処理を入れる |
| s.isdigit() で判定する | 誤判定する | try/except で判定する |
| except で全部受ける | バグを見逃す | ValueError, TypeError を指定する |
| 金額を float で計算する | 1円単位でずれる | Decimal を使う |
| Decimal(0.1) と書く | 誤差を引き継ぐ | Decimal(“0.1”) と文字列で渡す |
| int(float(s)) を忘れる | “1.0” でエラー | 小数点があるなら int(float(s)) |
エク短流:ExcelのデータをPythonで読むときの注意
ExcelやCSVから取り込んだ値は、次のような状態になっていることがあります。
| 状態 | 例 | 対処 |
|---|---|---|
| 金額にカンマが入っている | 1,234 | replace(“,”, “”) |
| 全角で入力されている | 1234 | NFKC正規化 |
| 単位が付いている | 1,234円 | 数字以外を除去 |
| 空欄がある | (空) | strip() と空チェック |
| 文字列として保存されている | ‘123 | 頭のシングルクォートを除去 |
| 作業 | Excel(VBA) | Python |
|---|---|---|
| 整数に変換 | CLng(“123”) | int(“123”) |
| 小数に変換 | CDbl(“123.45”) | float(“123.45”) |
| 変換できないとき | IsNumeric() で判定 | try/except で判定 |
| 全角数字 | StrConv(s, vbNarrow) | unicodedata.normalize(“NFKC”, s) |
VBAの IsNumeric() は判定用に使えますが、Pythonの isdigit() は判定に使えないという違いがあります。
「判定してから変換」ではなく、「変換してみて、失敗したら対処」と考えるのがPython流です。
さいごに
今回は、Pythonで文字列を数値に変換する方法をまとめました。
2. エラーは「ValueError=中身の問題」「TypeError=型の問題」で切り分ける
3. カンマ・通貨記号・全角は前処理で取り除く
4. isdigit() での判定はやめて、try/except で書く
5. 金額の計算は Decimal を使う
変換できない文字列に出会ったときは、まずエラー文の種類を見てください。それだけで原因の見当がつきます。
ValueError と TypeError の違いさえ押さえておけば、切り分けはカンタンですね。
文字列から数値への変換は、データ処理のいちばん最初の関門です。ここでつまずかなくなると、CSVもAPIもぐっと扱いやすくなりますね。
「1,234」のような値が出てきたときは、この手順をぜひ試してみてください。
最後までお読みいただきありがとうございました。
この記事の関連キーワード
「数値に変換」の関連記事
こちらの記事の内容「数値に変換」に関連する記事一覧です。

コメントを残す